Шаг 10: Изучение распределения ключевых слов
Попробуем использовать вкладку Ключевые слова, чтобы лучше понять особенности используемых слов. Переключитесь на вкладку Ключевые слова. На данной вкладке приводится статистика слов, которые используются в описании преступлений. Мы видим статистику ключевых слов в выбранной категории и можем сравнить ее с общей статистикой (статистикой слов любой категории/всех категорий).
Для каждого ключевого слова отображается следующая информация:
-
Значимость - мера уникальности ключевого слова для всех записей исследуемой колонки;
-
Частота - количество повторов слова в выбранной категории;
-
Поддержка - количество записей, в которых встречается слово;
-
Общая частота - общее количество повторов слова во всех записях (все 535);
-
Общая поддержка - общее количество записей, содержащих слово (все 535).
Частота/общая частота (%) - это отношение частоты слова в текущей категории к общей частоте слова. Значение 100% означает, в 100 % случаев, когда слово встречается в любом описании преступления, эта запись принадлежит выбранной категории.
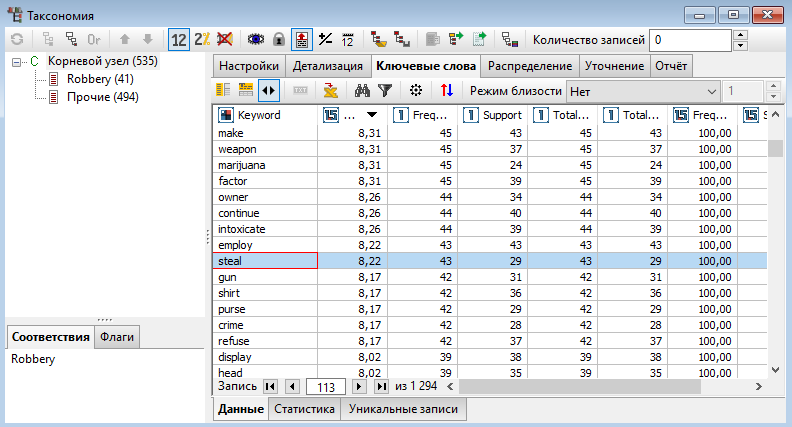
Например, на представленном выше скриншоте мы видим, что слово steal встречается в 43 записях исходной таблицы, и все 43 записей принадлежат категории Robbery, вот откуда здесь значение в 100 %.
Отсортируйте список ключевых слов по колонке Частота/общая частота (%). Как говорилось в разделе о cортировке данных, для этого вам необходимо нажать правой кнопкой мыши по названию колонки и в контекстном меню выбрать Сортировать по возрастанию/по убыванию. Отсортируйте данные по убыванию.
Если прокрутить вниз список слов со 100%-м коэффициентом, то первым словом с более низким коэффициентом окажется слово larceny. Это значит, что по крайней мере в одной записи, не принадлежащей категории Robbery, упоминается слово larceny. Мы задавали поиск фразы grand larceny, но один из полицейских при составлении описания не включил в него уточняющее слово grand, он упомянул лишь слово larceny. Это значит, что наше выражение оказалось слишком узким и конкретным. Попробуем изменить нашу категорию. Одним из преимуществ таксономии является то, что мы можем ее сразу редактировать.
Переключитесь на вкладку Настройки. Здесь мы можем изменить свойства выбранной категории Robbery. Часть выражения grand larceny замените на larceny, затем нажмите Обновить. Узел будет перевыполнен, результаты категоризации записей изменятся:
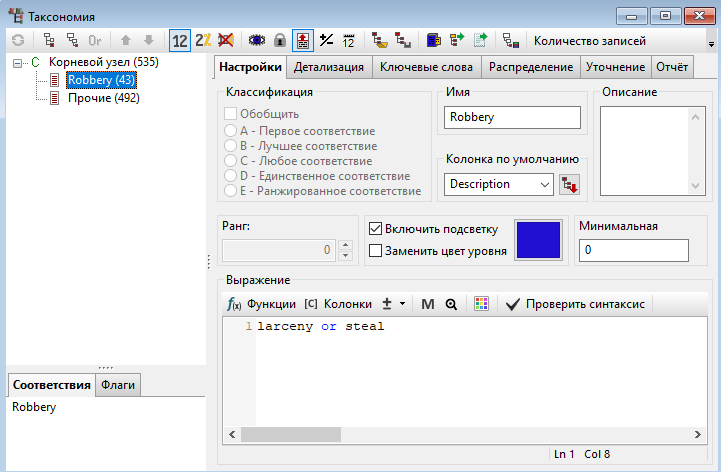
Обратите внимание на то, что в этот раз в категории оказалось 43 записи (вместо 41 в предыдущем результате). На вкладке Уточнение мы увидим, что имеем теперь 11 соответствий вместо 10. Таким образом, незначительное повышение точности было достигнуто за счет создания более общего запроса.
Несмотря на то, что мы находимся на правильном пути, у нас по-прежнему много записей, которые остались за пределами категории Robbery. Выберите категорию Прочие в дереве таксономии и откройте вкладку Детализация. Отсортируйте колонку Категория в возрастающем порядке, прокрутите список до категории Robbery и ознакомьтесь с некоторыми записями. Для вашего удобства текст одной из записей, который мы будем анализировать, а также его перевод на русский язык, приводится ниже:
Fairfax County Police are investigating a robbery that occurred in the parking lot of the Vienna Metro Station, located at 2850 Nutley Street in the Vienna area, about 7:45 p.m. Monday. A 24-year-old Centreville area man was walking in the lot when a man approached him from behind and put a hard object against his back. Another man approached from the front and told him not to move. He then removed the victim’s wallet and both suspects fled the area. The victim was not injured. The first suspect was described as black, six feet tall wearing a dark colored full length jacket. The second suspect was described as Hispanic, about 35 years old, five feet four inches tall, weighing 160 pounds. He had a mustache and short black hair. He was wearing a dark colored jacket and black jeans.
Полиция округа Фэйрфакс расследует ограбление, которое произошло примерно в 19:45 на автостоянке станции метро Вена, расположенной на улице Натли 2850. 24-летний мужчина из Сентревилла шел по автостоянке, когда к нему сзади подошел мужчина и приставил некий твердый предмет к спине. Другой мужчина подошел к нему и приказал не двигаться. Затем он вытащил бумажник жертвы, и оба мошенника скрылись. Жертва не получила телесных повреждений. Один из нападавших был чернокожий мужчина ростом 1,80 м., в длинной черной куртке. Второй, по словам жертвы преступления, был латиноамериканцем, примерно 35 лет, ростом 1,60 м., весом около 72,5 кг. У него были усы и короткие черные волосы. Был одет в темную куртку и черные джинсы.
Если вы внимательно прочитаете текст, наверняка, вы сразу поймете, почему запись не попала в нашу категорию, и что в нее нужно было бы добавить, чтобы запись была верно категоризована. Возможные слова-кандидаты (не все они одинаково хороши) выделены жирным шрифтом в том же тексте ниже:
Fairfax County Police are investigating a robbery that occurred in the parking lot of the Vienna Metro Station, located at 2850 Nutley Street in the Vienna area, about 7:45 p.m. Monday. A 24-year-old Centreville area man was walking in the lot when a man approached him from behind and put a hard object against his back. Another man approached from the front and told him not to move. He then removed the victim’s wallet and both suspects fled the area. The victim was not injured. The first suspect was described as black, six feet tall wearing a dark colored full length jacket. The second suspect was described as Hispanic, about 35 years old, five feet four inches tall, weighing 160 pounds. He had a mustache and short black hair. He was wearing a dark colored jacket and black jeans.
Из всех выделенных слов часть фразы removed the victim’s wallet кажется самой подходящей для улучшения поискового запроса. Выберите категорию Robbery в дереве таксономии еще раз, затем вернитесь на вкладку Настройки и измените поисковый запрос так, чтобы производился поиск слова removed в непосредственной близости от слова wallet. Мы можем определить такую близость как нахождение слов рядом друг с другом, либо нахождение слов в одном предложении или соответствие определенному шаблону (слово victim имеет определенное семантическое значение и не является стоп-словом, поэтому можно использовать PDL функцию pattern). Нам нужно, чтобы слова removed и wallet находились рядом друг с другом, поэтому близость в пределах одного предложения в нашем случае - слишком общая формулировка. Попробуем использовать функцию near, дополнительно указав, что между заданными словами может быть не больше 7 слов. Мы также можем включить слово robbery в выражение.
Теперь наша категория Robbery может выглядеть следующим образом:
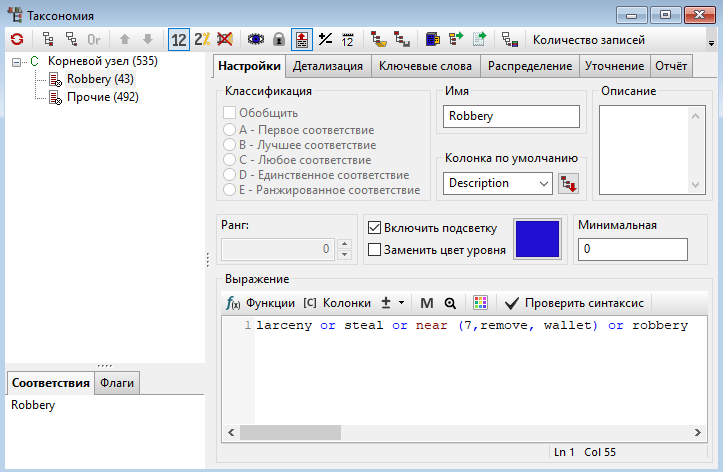
Нажмите Обновить. Перейдите к вкладке Уточнение и оцените результаты изменения параметров запроса путем поиска альтернативных слов и выражений.
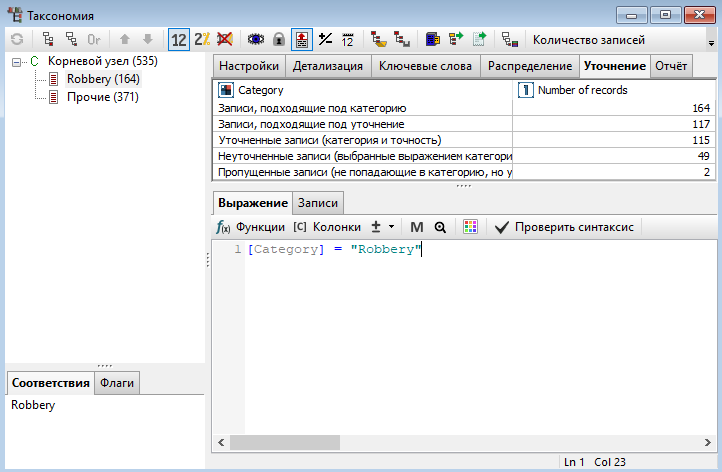
После внесения изменений в выражение категоризация оказалась более точной. Запрос выдал 164 соответствия. В данном случае мы получили 115 соответствий из возможных 117 случаев, когда офицер полиции вручную указал, что преступление относится к категории ограбление. Подобная точность позволяет утверждать, что мы сумели воспроизвести те же мыслительные операции, которые выполнял полицейский при выборе подходящей категории для преступлений.
На данном этапе мы, пожалуй, завершим наше упражнение. Вы в любое время можете попытаться выяснить, почему еще 2 записи не попали в категорию Robbery, хотя должны были, и почему в ней оказались лишние 49 записей. Более тщательно изучите ключевые слова и другие записи, чтобы понять, что необходимо изменить в поисковом выражении, затем обновите таксономию и проверьте результат. Подобная возможность редактирования таксономии с помощью отдельных итераций является главным преимуществом данного инструмента классификации текста в системе PolyAnalyst. Можете рассматривать свою работу с таксономией как выгодную инвестицию времени: в зависимости от того, сколько времени вы уделите настройке категорий, постепенно будет повышаться точность таксономии. Помните о том, что в рамках данного руководства мы использовали небольшую, хорошо знакомую вам таблицу данных. А что, если появятся новые данные, которые необходимо классифицировать в автоматическом режиме? Как будет работать ваша таксономия с новым текстом, при условии, что точность классификации бывает достаточно сложно оценить? Есть риск, что при работе с новыми описаниями ваша таксономия не будет давать абсолютно точный результат.
Работая только с одной категорией, невозможно понять все преимущества использования таксономии. В таком случае было бы более уместным использовать узел Поисковый запрос и Фильтрация строк. Поэтому теперь мы с вами попробуем расширить нашу таксономию, создав еще одну категорию.